


SpaceX AI stellt Grok 4.7 vor: Flaggschiff-Generation für Coding und Wissensarbeit zum gleichen Preis wie Grok 4.6
TradingKey – SpaceXAI (die KI-Sparte von SPXC, ehemals xAI) hat am 21. September Grok 4.7 veröffentlicht und positioniert es offiziell als seine bislang leistungsfähigste Modellgeneration für Programmierung und Wissensarbeit. Die Preise bleiben im Vergleich zu Grok 4.6 unverändert: 2 US-Dollar pro Million Input-Token und 6 US-Dollar pro Million Output-Token. Bei CursorBench 4.0, das speziell langlaufende Programmieraufgaben bewertet, erzielte Grok 4.7 ein Ergebnis von 46,3 % – 5,9 Prozentpunkte mehr als Grok 4.6. Nach offiziellen Angaben liegt es bei diesem Benchmark an der Spitze des Preis-Leistungs-Verhältnisses innerhalb seiner Preisklasse.
In den vergangenen zwei Jahren führten Leistungssteigerungen bei Spitzenmodellen typischerweise zu höheren Token-Stückpreisen: Generationen-Upgrades, Preiserhöhungen und das anschließende Warten darauf, dass die Branche die Inferenzkosten allmählich absorbiert. Grok 4.7 schlägt einen anderen Weg ein: Während die Leistungsfähigkeit weiter gesteigert wird, bleiben Preisgestaltung und Inferenzgeschwindigkeit auf dem Niveau von Grok 4.6, zusammen mit einer zusätzlichen schnellen Version, die die Ausgabegeschwindigkeit verdoppelt.
Die offiziell bekannt gegebenen Details konzentrieren sich auf vier Aspekte: Änderungen beim Basismodell und beim Reinforcement-Learning-Training, horizontale und vertikale Vergleiche über sieben Benchmarks hinweg, Kostenstrukturen bei langlaufenden Aufgaben sowie ein vollständig neu geschriebener Sicherheits-Guardrail-Stack. Darüber hinaus ist das Modell ab sofort gleichzeitig über Cursor, Grok Build, die Grok-API sowie Programmier-Frameworks von Drittanbietern und Modell-Routing-Plattformen verfügbar.
Das zentrale Leistungsversprechen von Grok 4.7 konzentriert sich auf drei Fähigkeiten: die Programmierung langlaufender Aufgaben, die Erstellung professioneller Dokumente und Sicherheits-Guardrails. Alle drei teilen dieselbe Preisstruktur – mit dem gleichen Preis und der gleichen Geschwindigkeit wie die Vorgängergeneration –, während eine schnelle Version genutzt wird, um latenzempfindliche Szenarien abzudecken.
Offizielle Benchmarks zeigen, dass die Fortschritte in dieser Modellgeneration kontinuierlich sind: CursorBench 4.0 verbesserte sich um 5,9 Prozentpunkte, Terminal-Bench 4.0 hat sich nahezu verdoppelt, AA Briefcase legte um 111 Punkte zu und das Modell erzielte das bisher höchste Ergebnis des Unternehmens bei Biosicherheits-Benchmarks. Zugleich verdeutlichen das absolute Niveau von 19,6 % bei juristischen Benchmarks und der Vorsprung von Fable 5.1 in vier Benchmarks, dass dies weiterhin eine Wettbewerbsrunde mit Gewinnen und Verlusten auf beiden Seiten ist und keine einseitige Ablösung.
Preise und Geschwindigkeit bleiben unverändert
Grok 4.7 startet bei 2 US-Dollar pro Million Input-Tokens und 6 US-Dollar pro Million Output-Tokens, identisch mit Grok 4.6, bei unveränderter Inferenzgeschwindigkeit. Eine offizielle Fast-Version ist ebenfalls verfügbar, die die doppelte Ausgabegeschwindigkeit der Standardversion zum doppelten Preis bietet.
Diese Preisgestaltung liegt im Vergleich zu ähnlichen Modellen am unteren Ende. Zum Vergleich: GPT-5.6 Sol kostet in der höchsten Stufe 4 US-Dollar für den Input und 20 US-Dollar für den Output, während Fable 5.1 in der höchsten Stufe 10 US-Dollar für den Input und 50 US-Dollar für den Output verlangt. Vergleicht man allein die Einzelpreise für den Output, liegt Grok 4.7 bei etwa einem Drittel des erstgenannten und rund einem Achtel des letztgenannten Modells.
Die praktische Auswirkung der unveränderten Preise sind überschaubare Migrationskosten. Teams, die bereits Grok 4.6 nutzen, können das Modell direkt in Cursor oder Grok Build wechseln und einen Vergleichstest mit ihren bestehenden Aufgaben-Suites durchführen, ohne dass Anpassungen an APIs oder Aufrufmethoden erforderlich sind.
Modellverbesserungen
Die Reinforcement-Learning-Phase für Grok 4.7 zeichnete sich zudem durch längere Trainingszeiten aus, wobei sich der Gesamtschwierigkeitsgrad der Trainingsaufgaben nach oben verschob und die Gewichtung stärker auf Probleme verlagert wurde, deren Bearbeitung Stunden erfordert. Das offizielle direkte Ergebnis ist, dass das Modell seine eigenen Ausgaben besser überprüfen und lange Kontexte besser verarbeiten kann.
Eine weitere Änderung betraf die Trainingsziele. Grok 4.7 wurde darauf trainiert, das Grok-Bot-Harness nativ zu verstehen, was eine bessere Leistung bei Dialogaufgaben und allgemeiner Wissensarbeit ermöglicht. SpaceXAI brachte Grok Bot am 11. August auf den Markt und beschrieb das System als eine Reihe kontinuierlich laufender Agenten, die jeweils mit einem eigenen Computer ausgestattet und in der Lage sind, innerhalb von Tools und Anwendungen zu arbeiten.
Die Fähigkeiten zur Erstellung von Dokumenten und Präsentationen wurden separat hervorgehoben. Offiziell zeigt Grok 4.7 in beiden Ausgabekategorien deutliche Verbesserungen gegenüber Grok 4.6 und agiert auf Augenhöhe mit anderen Frontier-Modellen.
Scorecard für sieben Benchmarks
Grok 4.7 schneidet bei der Erstellung von Dokumenten und Präsentationen besser ab. In den Tests GDPval und AA Briefcase ist die KI gefordert, die Arbeit von Fachkräften wie Juristen, Pflegekräften und Finanzanalysten zu übernehmen. Grok 4.7 übertraf Grok 4.6 in beiden Benchmark-Tests und erzielte eine Leistung auf Augenhöhe mit anderen Frontier-Modellen.
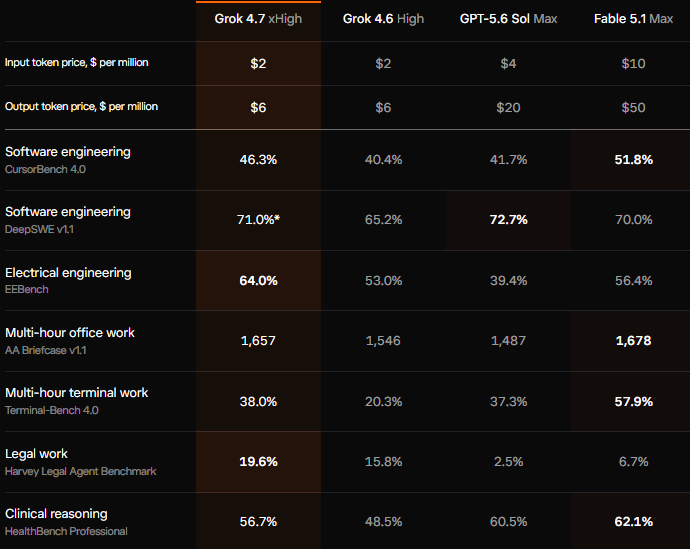
[Offizielle Vergleichstabelle zu Programmierung, Terminal-Operationen, Elektrotechnik, Recht, klinischer Urteilsfähigkeit und Büroaufgaben. Quelle: x.ai]
Die größten Fortschritte zeigten sich in den Bereichen Recht und Terminal-Operationen. Beim Harvey Legal Agent Benchmark erzielte Grok 4.7 mit 19,6 % den höchsten Wert in dieser Gruppe, während GPT-5.6 Sol lediglich 2,5 % erreichte; beim Terminal-Bench 4.0 sprang Grok 4.7 von 20,3 % bei Grok 4.6 auf 38,0 % und verdoppelte sich damit nahezu. Die klinische Urteilsfähigkeit verbesserte sich um 8,2 Prozentpunkte, und die Ergebnisse bei Büroaufgaben stiegen um 111 Punkte.
Die Kostenkurve bei langen Aufgaben
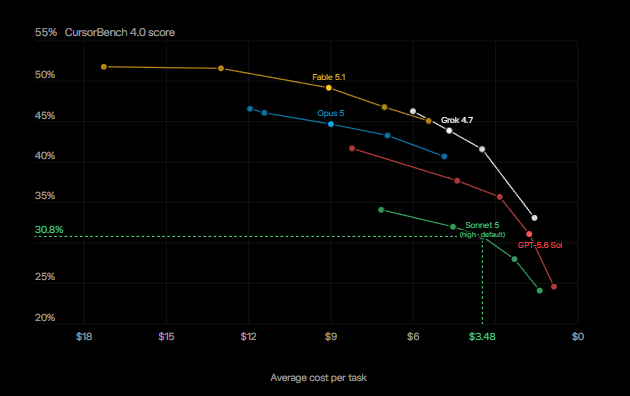
Die offizielle Seite für CursorBench 4.0 zeigt drei Diagramme nebeneinander: durchschnittliche Kosten pro Aufgabe, durchschnittliche Output-Tokens und durchschnittliche Schritte, wobei die vertikale Achse auf dieselbe Punkteskala standardisiert ist. Der Referenzpunkt in den Diagrammen ist bei Sonnet 5 (Voreinstellung „High“) markiert: eine Punktzahl von 30,8 %, 3,48 US-Dollar pro Aufgabe, etwa 61.000 Output-Tokens und 85 Schritte, was als Baseline für den Kosteneffizienzvergleich dient.
[Quelle: X.ai]
Beim Blick auf die Kostenkurve erreicht Fable 5.1 die höchste Punktzahl bei Kosten von fast 18 US-Dollar pro Aufgabe; GPT-5.6 Sol liegt auf der kostengünstigen Seite, wobei seine Punktzahl mit sinkenden Kosten deutlicher abfällt. Grok 4.7 ordnet sich zwischen den beiden ein, wobei offizielle Angaben das Modell an der Preis-Leistungs-Effizienzgrenze dieses Benchmarks sehen. Die Verläufe der Diagramme für Output-Tokens und Schrittanzahl spiegeln das Kostendiagramm wider, was darauf hindeutet, dass Kostenunterschiede in erster Linie auf die zur Aufgabenerfüllung erforderliche Reasoning-Länge und nicht auf den Einzelpreis selbst zurückzuführen sind.
Stellen Sie sich ein sechsköpfiges Backend-Team vor, das einen Dienst mit 400.000 Zeilen Code von einem alten Framework auf ein neues migriert. Eine solche Aufgabe in Einzelschritt-Commits zu zerlegen macht keinen Sinn; das Modell muss stundenlang kontinuierlich arbeiten und die Ergebnisse vorheriger Schritte laufend selbst überprüfen – genau das Szenario, das CursorBench 4.0 und Terminal-Bench 4.0 messen sollen. Erst wenn die Kosten pro Aufgabe von über zehn US-Dollar auf wenige US-Dollar sinken, wird ein Team dies voraussichtlich in den täglichen Arbeitsablauf einbinden, anstatt mit der Stapelverarbeitung bis zum Wochenende zu warten.
Sicherheit und Cybersicherheit
Grok 4.7 nutzt einen völlig neuen Sicherheits-Stack. Offiziell wird es als das bislang stärkste vom Unternehmen getestete Modell beschrieben, sowohl bei der Verweigerungsrate als auch bei der Jailbreak-Resistenz.
In Dual-Use-Bereichen wie Cybersicherheit und Biosicherheit decken die offiziellen Daten beide Seiten ab: Die Nutzbarkeit für legitime Aufgaben bleibt erhalten, während gefährliche Anfragen abgelehnt werden. Im Bereich Biosicherheit erzielte Grok 4.7 beim LatchBio-Biosicherheits-Benchmark 62,4 % – das höchste Ergebnis in diesem Benchmark. In der Cybersicherheit zeigte der hauseigene Benchmark HackerBench v0.3, dass das Modell nur 3,3 % der risikoreichen Dual-Use-Prompts zuließ, während legitime Sicherheitsforschung nur selten blockiert wurde.
SpaceXAI gab zudem bekannt, dass das Unternehmen begonnen hat, ausgewählten Cybersicherheitspartnern Zugang auf Einladung zu den Red-Teaming-Funktionen von Grok 4.7 für defensive Forschung anzubieten.
Empfohlene Artikel


