


SpaceX AI presenta Grok 4.7: generación insignia para programación y trabajo intelectual al mismo precio que Grok 4.6
TradingKey - SpaceXAI (SPXC, su división de IA, anteriormente xAI) lanzó Grok 4.7 el 21 de septiembre, posicionándolo oficialmente como su generación de modelos más capaz hasta la fecha para tareas de programación y trabajo del conocimiento. El precio se mantiene constante respecto a Grok 4.6: $2 por millón de tokens de entrada y $6 por millón de tokens de salida. En CursorBench 4.0, que evalúa específicamente tareas de programación de larga duración, Grok 4.7 obtuvo un 46,3%, 5,9 puntos porcentuales más que Grok 4.6, y las afirmaciones oficiales lo sitúan en la frontera de coste-rendimiento dentro de su nivel de precio en este benchmark.
Durante los últimos dos años, las mejoras de capacidad en los modelos insignia generalmente se han traducido en precios unitarios por token más elevados: actualizaciones generacionales, subidas de precios y la posterior espera a que la industria absorba gradualmente los costes de inferencia. Grok 4.7 sigue un camino diferente: aunque eleva sus capacidades, su precio y velocidad de inferencia se mantienen al nivel de Grok 4.6, junto con una versión rápida adicional que duplica la velocidad de salida.
Los detalles revelados oficialmente se centran en cuatro aspectos: cambios en el modelo base y en el entrenamiento por aprendizaje por refuerzo, comparaciones horizontales y verticales en siete benchmarks, estructuras de costes en tareas de larga duración y un sistema de barreras de seguridad completamente reescrito. Además, con efecto inmediato, el modelo está disponible simultáneamente en Cursor, Grok Build, Grok API y en entornos de programación y plataformas de enrutamiento de modelos de terceros.
La propuesta de valor central de Grok 4.7 se centra en tres capacidades: programación de tareas de larga duración, generación de documentos profesionales y barreras de seguridad. Las tres comparten la misma estructura de precios —ofreciendo el mismo precio y velocidad que la generación anterior—, mientras que recurren a una versión rápida para cubrir escenarios sensibles a la latencia.
Los benchmarks oficiales indican que el avance de esta generación de modelos es continuo: CursorBench 4.0 mejoró 5,9 puntos porcentuales, Terminal-Bench 4.0 casi se duplicó, AA Briefcase ganó 111 puntos y se alcanzó la puntuación más alta de la empresa en evaluaciones de bioseguridad. Al mismo tiempo, el nivel absoluto del 19,6% en benchmarks legales y el liderazgo de Fable 5.1 en cuatro benchmarks demuestran que esta sigue siendo una ronda de competencia con victorias y derrotas en ambos lados, en lugar de una sustitución unilateral.
Precios y velocidad se mantienen sin cambios
Grok 4.7 parte de 2 dólares por millón de tokens de entrada y 6 dólares por millón de tokens de salida, idéntico a Grok 4.6, al tiempo que mantiene la misma velocidad de inferencia. También hay disponible una versión rápida oficial que ofrece el doble de velocidad de salida que la versión estándar al doble de precio.
Este nivel de precios se ubica en la parte baja entre los modelos comparables. En comparación, GPT-5.6 Sol cuesta 4 dólares por entrada y 20 dólares por salida en su nivel máximo, mientras que Fable 5.1 cuesta 10 dólares por entrada y 50 dólares por salida en su nivel máximo. Si se comparan únicamente los precios unitarios de salida, Grok 4.7 representa aproximadamente un tercio del primero y alrededor de un octavo del segundo.
El impacto práctico de mantener los precios sin cambios es un coste de migración asumible. Los equipos que ya utilizan Grok 4.6 pueden cambiar de modelo directamente en Cursor o Grok Build y realizar una prueba comparativa con sus conjuntos de tareas existentes, sin necesidad de realizar cambios en las API ni en los métodos de invocación.
Mejoras del modelo
La fase de aprendizaje por refuerzo de Grok 4.7 también contó con tiempos de entrenamiento más prolongados, en los que la combinación general de dificultad de las tareas de entrenamiento se desplazó hacia arriba y la ponderación se inclinó hacia problemas que requerían horas para completarse. El resultado directo oficial es que el modelo cuenta con una mayor capacidad para verificar sus propios resultados y gestionar contextos extensos.
Otro cambio se produjo en los objetivos de entrenamiento. Grok 4.7 fue entrenado para comprender de forma nativa el entorno de Grok Bot, ofreciendo un mejor rendimiento en tareas conversacionales y trabajos de conocimiento general. SpaceXAI lanzó Grok Bot el 11 de agosto y lo describió como un conjunto de agentes en ejecución continua, cada uno equipado con su propia computadora y capaz de trabajar dentro de herramientas y aplicaciones.
Las capacidades de generación de documentos y presentaciones se destacaron por separado. Oficialmente, Grok 4.7 muestra mejoras notables con respecto a Grok 4.6 en ambas categorías de generación, rindiendo a la par de otros modelos de frontera.
Cuadro de mando para siete referencias
Grok 4.7 ofrece un mejor rendimiento en la creación de documentos y presentaciones. En las pruebas GDPval y AA Briefcase, la IA debe realizar el trabajo de profesionales como abogados, personal de enfermería y analistas financieros. Grok 4.7 superó a Grok 4.6 en ambas pruebas de referencia y alcanzó un rendimiento a la par de otros modelos de frontera.
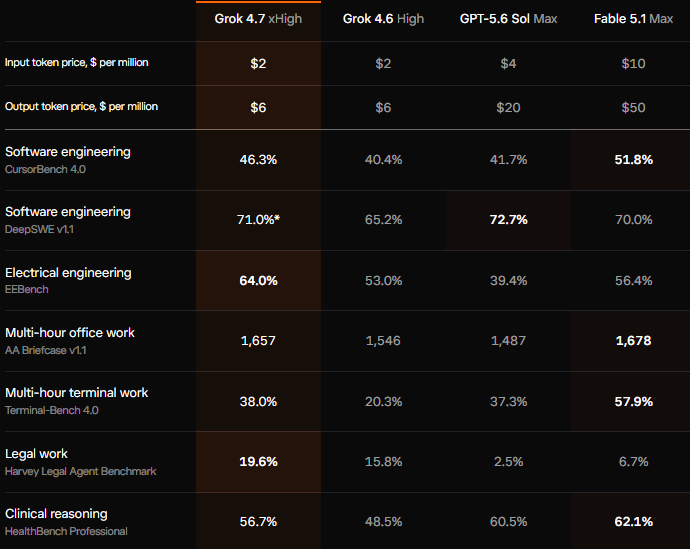
[Tabla comparativa oficial que abarca programación, operaciones de terminal, ingeniería eléctrica, derecho, razonamiento clínico y tareas de oficina. Fuente: x.ai]
El derecho y las operaciones de terminal mostraron las mayores mejoras. En la evaluación Harvey Legal Agent Benchmark, Grok 4.7 obtuvo un 19,6%, la puntuación más alta de este grupo, mientras que GPT-5.6 Sol solo alcanzó un 2,5%; en Terminal-Bench 4.0, Grok 4.7 se disparó desde el 20,3% de Grok 4.6 hasta el 38,0%, casi duplicando su cifra. El razonamiento clínico mejoró en 8,2 puntos porcentuales y las puntuaciones en tareas de oficina aumentaron en 111 puntos.
La curva de costos en tareas de larga duración
La página oficial de CursorBench 4.0 presenta tres gráficos lado a lado: coste medio por tarea, promedio de tokens de salida y promedio de pasos, con el eje vertical estandarizado para la misma serie de puntuaciones. El punto de referencia en los gráficos está marcado en Sonnet 5 (configuración predeterminada alta): una puntuación del 30,8%, 3,48 dólares por tarea, aproximadamente 61.000 tokens de salida y 85 pasos, lo que sirve como línea de base para la comparación de la relación coste-eficiencia.
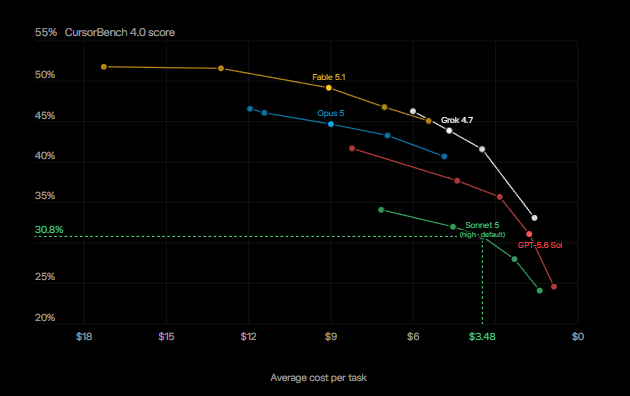
[Fuente: X.ai]
Al observar la curva de costes, Fable 5.1 alcanza la puntuación más alta, con un coste de casi 18 dólares por tarea; GPT-5.6 Sol se sitúa en el lado de bajo coste, y su puntuación cae de forma más pronunciada a medida que el coste disminuye. Grok 4.7 se ubica entre los dos, y las afirmaciones oficiales lo sitúan en la frontera de coste-rendimiento en este benchmark. La forma de los gráficos de tokens de salida y de recuento de pasos refleja la del gráfico de costes, lo que indica que las diferencias de coste obedecen principalmente a la longitud del razonamiento necesario para completar las tareas, y no al precio unitario en sí.
Imagine a un equipo de backend de seis personas que migra un servicio de 400.000 líneas de un framework antiguo a uno nuevo. Dividir este tipo de tareas en commits de un solo paso no tiene sentido; el modelo debe trabajar de manera continua durante horas y verificar por sí mismo los resultados de los pasos anteriores sobre la marcha, exactamente el escenario que CursorBench 4.0 y Terminal-Bench 4.0 buscan medir. Solo cuando el coste por tarea se reduzca de más de diez dólares a unos pocos dólares, un equipo probablemente lo integrará en sus rutinas diarias, en lugar de esperar a procesarlo en lotes durante el fin de semana.
Seguridad y ciberseguridad
Grok 4.7 utiliza una pila de seguridad totalmente nueva. Oficialmente, se describe como el modelo más sólido de la compañía probado hasta la fecha, tanto en tasa de rechazo como en resistencia a jailbreaks.
En ámbitos de doble uso, como la ciberseguridad y la bioseguridad, los datos oficiales abarcan ambos aspectos: mantener la utilidad para tareas legítimas al tiempo que se rechazan solicitudes peligrosas. En bioseguridad, Grok 4.7 alcanzó un 62,4% en la evaluación comparativa de bioseguridad LatchBio, la puntuación más alta en la prueba. En ciberseguridad, la evaluación comparativa interna HackerBench v0.3 mostró que el modelo solo permitió un 3,3% de los prompts de doble uso de alto riesgo, mientras que rara vez bloqueó la investigación de seguridad legítima.
SpaceXAI también afirmó que ha comenzado a ofrecer acceso exclusivo por invitación a las capacidades de red teaming de Grok 4.7 a socios de ciberseguridad seleccionados para la investigación defensiva.
Artículos Recomendados


