


Grok 4.7 de xAI supera a los modelos de Anthropic y OpenAI en el trabajo de agente legal por menos
Grok 4.7 fue lanzado por xAI el lunes. Superó a Fable 5.1 de Anthropic y a GPT-5.6 Sol de OpenAI en una prueba comparativa de agentes legales, cobrando una quinta parte del precio de Fable por token de entrada.
La producción se sitúa en 6 dólares por millón de tokens frente a los 50 dólares de Anthropic
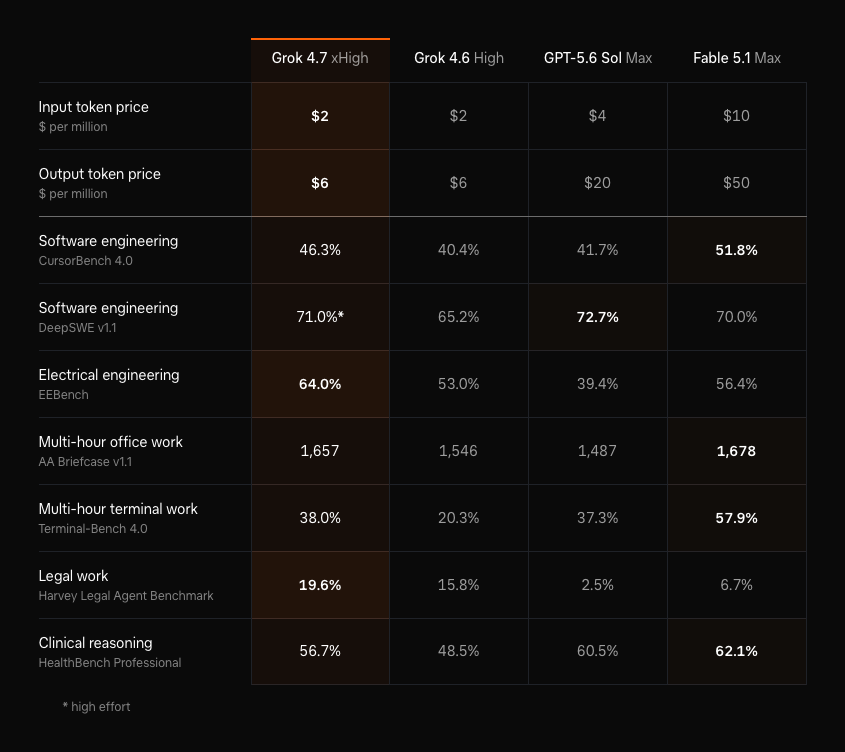
Según el comunicado de xAI, Grok 4.7 obtuvo un 19,6% en la prueba comparativa Harvey Legal Agent. Fable 5.1 obtuvo un 6,7% en la misma prueba y GPT-5.6 Sol un 2,5%.
Eso sitúa a Grok 4.7 en aproximadamente tres veces la puntuación de Anthropic y cerca de ocho veces la de Sol. Cryptopolitan informó el mes pasado que Grok 4.6 ya superaba a ese dúo con un 15,8%.
El ámbito jurídico es uno de los pocos en los que Grok 4.7 supera claramente a sus dos competidores. Además, supera a Fable 5.1 en la prueba de ingeniería eléctrica EEBench y lo aventaja ligeramente en la prueba de codificación DeepSWE.
El precio de Grok 4.7 es de 2 dólares por millón de tokens de entrada y 6 dólares por millón de tokens de salida, lo mismo que Grok 4.6. Esa tasa de entrada es la mitad de los 4 dólares de GPT-5.6 Sol y una quinta parte de los 10 dólares de Fable 5.1.
El precio de salida es de 6 dólares, frente a los 20 dólares de Sol y los 50 dólares de Fable, aproximadamente una octava parte del precio de Anthropic.
xAI comparó las puntuaciones de CursorBench 4.0 con el coste medio por tarea completada y afirma que el modelo se sitúa en la frontera precio-rendimiento. Grok 4.7 obtiene alrededor del 46 % en ese gráfico con un coste aproximado de 6 dólares por tarea, mientras que Claude Opus 5 necesita casi el doble de inversión para obtener un resultado similar.
Fable 5.1 funciona mejor con presupuestos más altos, llegando hasta el 51,8% con alrededor de $17 por tarea. El lanzamiento fue "unatroncombinación de inteligencia, velocidad y bajo costo", dijo Musk en X.
Terminal-Bench 4.0 otorga a Anthropic una ventaja del 57,9% frente al 38,0%
Grok 4.7 quedó en segundo lugar, detrás de Fable 5.1, en GDPval y en la prueba de trabajo de oficina AA Briefcase. El modelo de Anthropic mantiene una clara ventaja en pruebas de codificación más largas y en pruebas de rendimiento de terminales.
El mayor margen se observa en Terminal-Bench 4.0, donde Fable 5.1 obtuvo un 57,9% frente al 38,0% de Grok 4.7, una diferencia de unos 20 puntos.
Fable también lidera en CursorBench y en el razonamiento clínico de HealthBench Professional, donde GPT-5.6 Sol también supera a Grok.
Grok 4.7 obtuvo 1695 puntos Elo en GDPval, que evalúa a los modelos en tareas realizadas por abogados, enfermeras y analistas financieros, un aumento con respecto a los 1605 puntos de Grok 4.6. Esto lo sitúa por debajo de los 1735 puntos de Fable 5.1, pero por delante de los 1542 que obtuvo el nuevo GPT-6 Astra de OpenAI en la misma tabla.
Grok 4.7 supera a GPT-5.6 Sol en cinco de los siete benchmarks. Solo pierde en DeepSWE y en la prueba clínica.
Grok 4.7 funciona con 2,1 billones de parámetros, un 40 % más que los 1,5 billones que impulsaban Grok 4.6. xAI ha incluido datos de entrenamiento complementarios de SpaceX, incluidos datos de telemetría de satélites Starlink y registros de fabricación.
La empresa afirma que es más probable que el modelo dedique más tiempo a los problemas difíciles y verifique sus propias respuestas que Grok 4.6.
El modelo se lanzó en la aplicación Grok, Cursor, Grok Build y la API xAI, sin lista de espera.
Todas las cifras que se muestran aquí provienen de las pruebas realizadas por xAI. CursorBench, la prueba principal de xAI, es desarrollada por Cursor, empresa que SpaceX finalizó su adquisición el mes pasado.
xAI se comparó con GPT-5.6 Sol, y el más reciente GPT-6 Astra de OpenAI aparece únicamente en los gráficos GDPval, AA Briefcase y EEBench.
No te limites a leer noticias sobre criptomonedas. Entiéndelas. Suscríbete a nuestro boletín. Es gratis.
Artículos Recomendados


