


A disputa entre a OpenAI e a Microsoft sobre os direitos de autor torna-se um teste para o modelo de negócio da IA
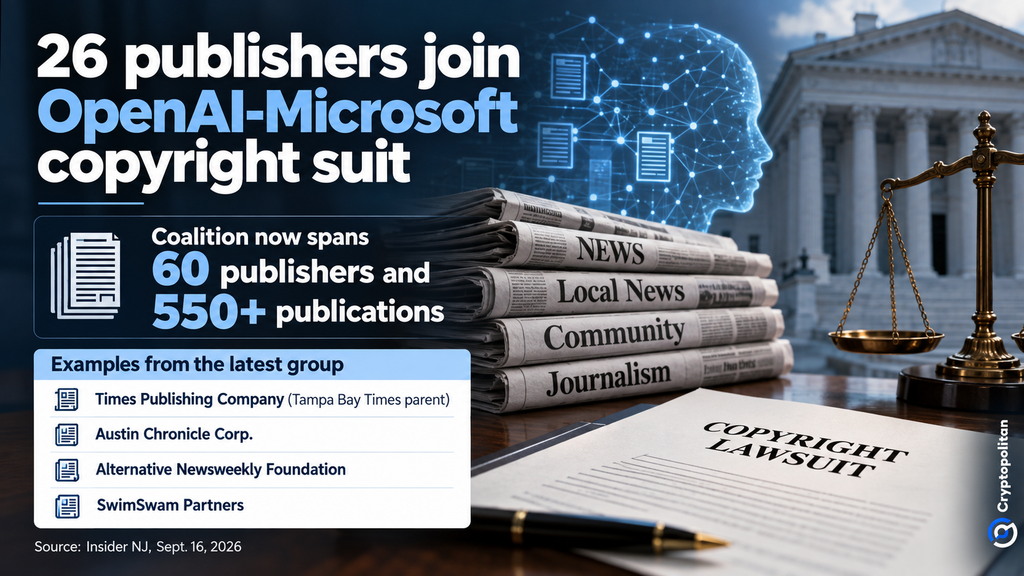
mais 26 editoras juntaram-se ao processo contra a OpenAI e a Microsoft, elevando o número total de editoras que aderiram à coligação para mais de 550. Isto torna o caso de grande escala, definindo a forma como as empresas de IA generativa obtêm e pagam pelo conteúdo que utilizam para criar os seus produtos.
A questão essencial no cerne do caso é um ponto fundamental que pode mudar as regras do jogo no campo das operações de IA: o que é considerado uso justo quando se trata de utilizar material protegido por direitos de autor na formação de grandes modelos de linguagem? A resposta pode afectar os custos de licenciamento, o acesso a dados de formação de qualidade e, em última análise, quais as empresas que se podem dar ao luxo de competir.
Uma coligação que continua a crescer
Segundo o escritório de advogados Platkin LLP, representa agora 60 editoras no processo. Entre elas, estão a Times Publishing Company, empresa-mãe do Tampa Bay Times; a Austin Chronicle Corp.; a Alternative Newsweekly Foundation; e a SwimSwam Partners.
As editoras acusam a OpenAI e a Microsoft de utilizarem os seus trabalhos sem consentimento ou qualquer compensação financeira para desenvolver produtos de IA com fins lucrativos e de terem apagado os dados de direitos de autor, incluindo os nomes dos autores e os avisos de direitos de autor. Platkin acredita que o surgimento desta coligação indica que as editoras começam a ver estas ações como uma ameaça não só à proteção dos direitos de autor, mas também à própria economia do jornalismo.
“A dimensão desta coligação deveria servir de alerta.” — Matt Platkin, sócio da Platkin LLP
Esta questão está a ser amplificada num grupo maior de casos. O caso da Richner Communications foi combinado com o litígio contra a OpenAI num conjunto maior de processos judiciais, enquanto outras editoras também estão a apresentar processos separadamente. Por exemplo, o Seattle Times e o Newsday processaram a OpenAI e a Microsoft por utilização indevida de conteúdos dos seus sites, incluindo conteúdos pagos para os produtos ChatGPT, Microsoft Copilot e Bing AI.
Porque é que o dia 4 de setembro é importante?
No dia 4 de setembro, foram apresentados pedidos concorrentes de julgamento sumário no caso In re OpenAI, Inc. Copyright Infringement Litigation. Os titulares dos direitos de autor alegam que a cópia realizada para a criação dos seus modelos não pode ser classificada como fair use e tem repercussões negativas para os mercados existentes e futuros. Por sua vez, a OpenAI e a Microsoft afirmam que os processos de formação devem ser interpretados como transformativos, uma vez que os modelos são ensinados a reconhecer padrões, em vez de adquirir informação da obra original, de acordo com o Centro de IA e Política Digital.
Ora, a mesma questão do uso justo estátracopiniões de terceiros. O juiz distrital dos EUA, Sidney H. Stein, que preside aos casos no Distrito Sul de Nova Iorque, convidou a apresentação de pareceres de amicus curiae até 16 de outubro. O Departamento de Justiça dos EUA já se tinha manifestado a 2 de setembro, manifestando o seu apoio a uma interpretação ampla do termo "uso justo" no contexto da formação em IA e alertando que o licenciamento obrigatório poderia criar obstáculos para as empresas mais pequenas.
Nem todas as decisões judiciais são contrárias à IA
O cenário jurídico é ainda incerto. A 16 de setembro, a OpenAI e a Microsoft ganharam parte do caso dos programadores do GitHub Copilot, com o tribunal de recurso a rejeitar uma teoria sobre a informação de gestão de direitos de autor, enquanto mantinha outras alegações em aberto.
O Gabinete de Direitos de Autor dos EUA afirma que o uso justo na formação em IA é específico de cada caso e pode depender do material utilizado, da forma como foi obtido, do motivo da cópia e do seu impacto nos mercados de direitos de autor. Uma decisão favorável às empresas de IA relativamente à formação não resolveria necessariamente os litígios sobre material pirateado ou obtido de forma inadequada.
Qual seria o custo do licenciamento?
O Gabinete de Direitos de Autor defende que se desenvolvam mercados de licenciamento voluntário antes de o Congresso considerar o licenciamento obrigatório, embora reconheça que o licenciamento de material à escala de formação em IA pode acarretar encargos financeiros e logísticos substanciais.
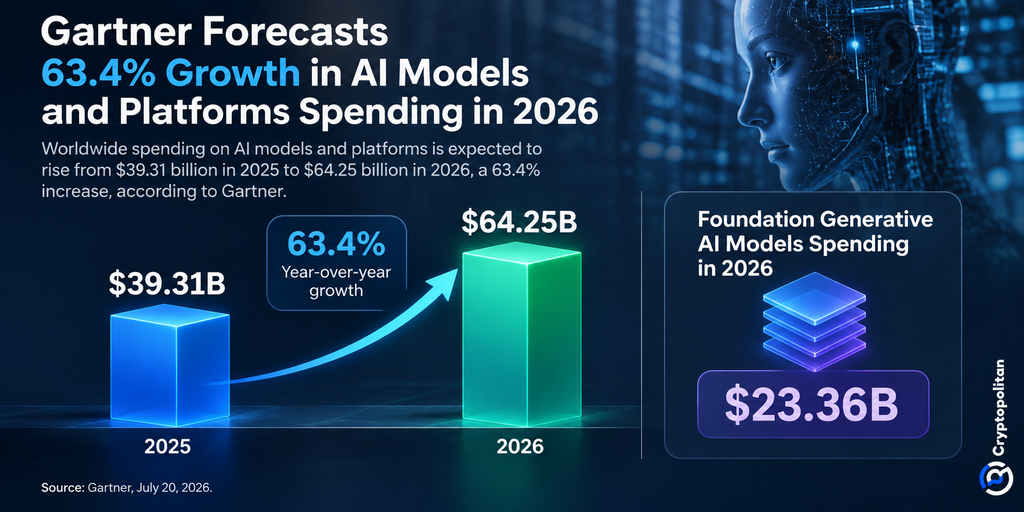
É aí que a previsão da Gartner se torna relevante. Prevê-se que os gastos mundiais com modelos e plataformas de IA subam de 39,31 mil milhões de dólares em 2025 para 64,25 mil milhões de dólares em 2026, um aumento de 63,4%. Só os modelos básicos de IA generativa têm uma previsão de custos de 23,36 mil milhões de dólares. Qualquer mudança no sentido do acesso pago a material de formação afectaria, portanto, um mercado em rápido crescimento, onde os custos com dados poderiam representar uma fatia muito maior da factura.
Estes custos podem não afetar todos da mesma forma. A OCDE afirma que os mercados de IA continuam dinâmicos, mas alerta que o acesso concentrado aos dados, ao poder computacional e às infraestruturas na nuvem pode fortalecer as empresas já estabelecidas. Os dados de formação protegidos por direitos de autor podem tornar-se outro insumo caro que os grandes desenvolvedores estão mais bem preparados para absorver.
A questão também está a tornar-se global. Na Europa, o código de IA de utilização geral da UE fornece uma estrutura para o cumprimento das obrigações de direitos de autor da Lei de IA.
O desafio reside em equilibrar uma remuneraçãotronpara os criadores com o risco de encarecer o desenvolvimento de modelos. A forma como os tribunais definem este limite ajudará a determinar não só a forma como as empresas de IA obtêm dados de formação, mas também se estes custos irão alargar ou restringir o leque de empresas capazes de construir a próxima geração de modelos.
Se você está lendo isto, já está um passo à frente. Continue assim assinando nossa newsletter.
Artigos Recomendados


