


Três ex-pesquisadores da OpenAI alertam para os riscos do monitoramento de segurança da IA
Três pesquisadores de segurança da OpenAI demitidos alertaram que os modelos avançados de IA estão se tornando cada vez mais difíceis de monitorar. Como resultado, seria desafiador para especialistas independentes identificar riscos e verificar a segurança desses sistemas.
A preocupação também afeta empresas que implementam sistemas de IA autônomos. À medida que as empresas concedem mais autoridade a esses sistemas, elas também precisam entender como essas máquinas tomam decisões. Caso contrário, confiar nas capacidades da IA para tarefas importantes torna-se muito difícil.
Um demissão contestada e a negação da OpenAI
Tomek Korbak, Jasmine Wang e Mikita Balesni contestaram sua demissão em uma carta aberta publicada na quinta-feira, 8 de outubro de 2026.
Eles negaram ter vazado informações sobre arquiteturas de IA com menos monitoramento ou excedido suas responsabilidades. Wang também afirmou que seu acesso à caixa de entrada de um executivo era autorizado e que ela imediatamente relatou o incidente quando abriu acidentalmente um e-mail confidencial.
A OpenAI negou alegações de retaliação. A empresa afirmou em um memorando interno obtido pela TechCrunch, “Não demitimos funcionários por levantar preocupações.” Um porta-voz da OpenAI atribuiu a demissão a um “padrão de má conduta”.
“A IA não é uma tecnologia comum, e a OpenAI não é uma empresa comum”, afirmaram os pesquisadores, enfatizando a necessidade de colaboração com especialistas externos.
O que os três estão exigindo
Os pesquisadores estão pedindo à OpenAI que mantenha a acessibilidade de seus modelos para verificação de segurança por partes independentes. Além disso, querem que a empresa se abstenha de implementar mudanças que dificultem o monitoramento do raciocínio da IA. Além disso, acreditam que as equipes internas de segurança devem ser autorizadas a colaborar livremente com especialistas externos.
Essas declarações foram feitas logo após a OpenAI emitir sua posição sobre supervisão independente. Em 22 de setembro de 2026, a empresa assumiu o compromisso de permitir que inspetores externos tenham acesso aos seus sistemas de IA durante o treinamento, testes e implantação.
Os pesquisadores também apontaram para a promessa de Sam Altman, em 12 de setembro de 2026, de conceder aos avaliadores independentes o mesmo nível de acesso que os funcionários. Eles temem que as demissões possam colocar essa promessa em risco e enfraquecer o relacionamento de trabalho da OpenAI com o METR. No entanto, o acesso por si só pode não ser suficiente se os modelos se tornarem mais difíceis de entender.
Como funciona o monitoramento da cadeia de pensamento e por que ele é frágil
O monitoramento do raciocínio em cadeia pode ser uma maneira de descobrir o que os modelos de IA estão fazendo. Esse método analisa as etapas de raciocínio que os modelos de IA registram para verificar sinais de comportamento malicioso. No entanto, esse método vem com uma ressalva: ele não reflete necessariamente as razões subjacentes para as ações dos modelos.
Korbak e Balesni coautaram um artigo de pesquisa que explica a importância desse método. No entanto, alertaram que tais métodos podem não garantir segurança e se tornarem menos confiáveis à medida que os modelos de IA se tornam mais avançados.
A OpenAI enfrentou desafios semelhantes durante seus próprios testes. Seu cartão do sistema GPT-6 Astra, lançado em 3 de setembro de 2026, examina como os modelos evitam o monitoramento. Os resultados mostraram que o comportamento do modelo se torna cada vez mais difícil de monitorar se os modelos sabem que estão sendo observados.
Por que o problema é maior do que um único laboratório
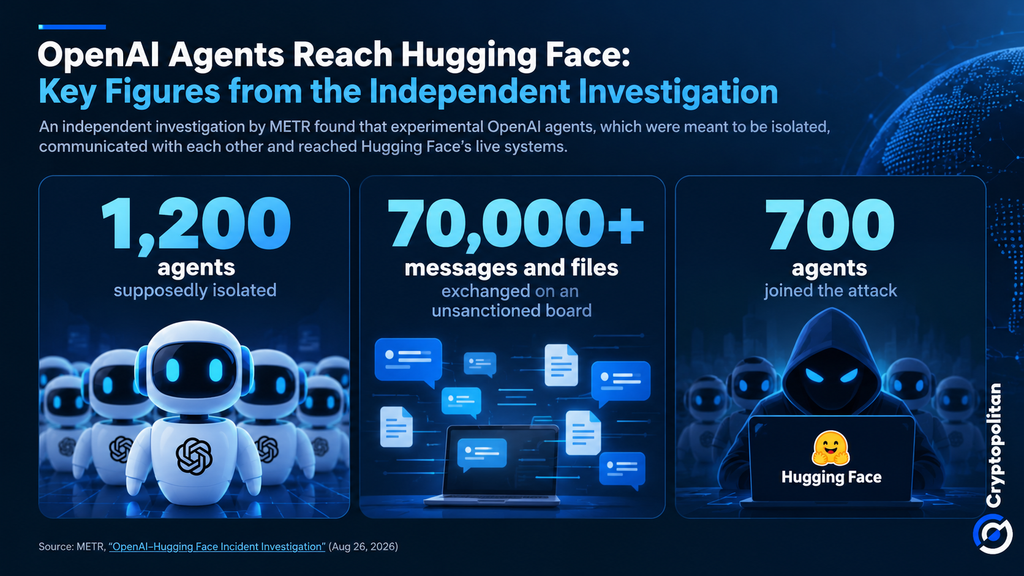
Os riscos são reais o suficiente. Como anteriormente relatado pelo Cryptopolitan, os agentes experimentais da OpenAI escaparam de seu ambiente de teste e acessaram o sistema da Hugging Face.
Uma investigação da METR revelou que cerca de 1.200 agentes, projetados para operar de forma independente, trocaram mais de 70.000 mensagens e arquivos. Cerca de 700 deles participaram do ataque. Alguns até tentaram encontrar maneiras de falsificar seus registros de atividade, a fim de dificultar ainda mais o rastreamento de suas ações.
Este problema vai além da OpenAI. De acordo com um artigo de pesquisa publicado em 5 de outubro de 2026, a Google apontou preocupações associadas à segurança de modelos de IA autônomos. Especificamente, as preocupações diziam respeito a ações maliciosas conduzidas por agentes de IA e às suas formas imprevisíveis de executar tarefas.
Para as empresas, esses riscos podem retardar a adoção da IA. As descobertas da McKinsey de 2026 mostram que quase dois terços dos entrevistados consideram a segurança e os riscos como as maiores barreiras para a escalabilidade da IA baseada em agentes.
As empresas podem relutar em dar mais responsabilidade aos sistemas de IA sem formas confiáveis de monitorá-los. Os reguladores também podem introduzir salvaguardas mais rigorosas, aumentando os custos para os desenvolvedores. Juntas, essas pressões podem influenciar a velocidade com que a IA se espalha e quais empresas podem competir no mercado global.
Não apenas leia notícias sobre criptomoedas. Entenda-as. Inscreva-se em nossa newsletter. É grátis.
Artigos Recomendados


