


Anthropic Revela Claude Opus 5.5: Custos 40% Menores, Maior Velocidade, Segurança Aprimorada e Capacidades Superiores em Tarefas Longas
TradingKey — Em 22 de setembro, no horário da costa leste dos EUA, a Anthropic anunciou o lançamento do Claude Opus 5.5, focado em três aspectos principais: maior capacidade para lidar com tarefas complexas, custos operacionais mais baixos e uso mais seguro. Em comparação com o Opus 5, seu custo por tarefa caiu 40% e sua velocidade de saída aumentou mais de 30%; os preços de entrada, saída e leitura de cache também foram reduzidos simultaneamente.
O ponto mais notável desta atualização talvez não seja liderar um benchmark isolado, mas sim o fato de que o modelo passa a se comportar mais como um parceiro colaborativo de longo prazo. Ele é capaz de lidar com migrações de código em grande escala, organizar materiais de negócios e gerar relatórios analíticos, ao mesmo tempo em que apresenta respostas de maneira mais direta e fáceis de revisar.
Programação Complexa Economiza Mais Tempo
A capacidade mais proeminente do Opus 5.5 está concentrada em tarefas de programação em grande escala e em múltiplas etapas que exigem verificação contínua. Em um teste, o Opus 5.5 revisou e corrigiu uma base de código de 200.000 linhas em menos de 3 horas. Enquanto isso, o Opus 5 levou mais de 20 horas e consumiu cerca de 2,5 vezes mais tokens. Para as empresas, isso significa que o valor da IA reside não apenas em "se ela consegue escrever código", mas também em se ela pode evitar desvios e economizar tempo.
[Fonte: Anthropic]
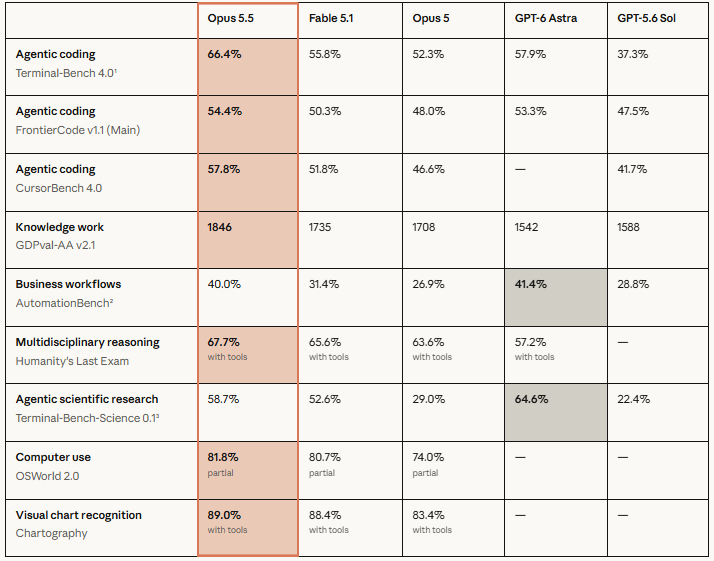
Os dados de teste também mostram que o Opus 5.5 atingiu 66,4% no Terminal-Bench 4.0, 54,4% no FrontierCode v1.1 e 57,8% no CursorBench 4.0. Embora esses números não possam representar todo o trabalho do mundo real, eles demonstram sua maior capacidade de lidar com tarefas de longa duração e em múltiplas etapas.
Capacidades de Escritório e Pesquisa Também Melhoram
Os casos de uso do Opus 5.5 vão além dos programadores. Os testes da Anthropic abrangem processos de negócios, trabalho intelectual, pesquisa científica, operação de computadores e reconhecimento de gráficos.
No teste de trabalho intelectual GDPval-AA v2.1, o Opus 5.5 obteve 1.846 pontos, superando os 1.735 pontos do Fable 5.1 e os 1.708 pontos do Opus 5. No teste de operação de computadores, sua pontuação foi de 81,8%, enquanto atingiu 89% no teste de reconhecimento de gráficos.
Um detalhe nas tarefas de pesquisa é particularmente interessante. Os avaliadores pediram a diversos modelos que elaborassem relatórios com base em informações de relatórios financeiros difíceis de encontrar e verificassem números e citações linha por linha. O Opus 5.5 atendeu aos padrões de qualidade 16 vezes em diferentes configurações, enquanto os outros dois modelos não conseguiram passar nenhuma vez. Isso demonstra que ele dá maior ênfase a evidências ao organizar informações, embora ainda não possa substituir a verificação humana.
Por exemplo, a empresa de investimentos Walleye Capital incumbiu o modelo de analisar uma fusão corporativa fictícia. Ele não apenas concluiu o modelo financeiro, mas também identificou um erro nas instruções do teste e o corrigiu de forma proativa. Para os usuários comuns, essa capacidade se traduz em análises de mercado mais claras, organização orçamentária e materiais de apresentação.
Queda de Preços É a Principal Mudança
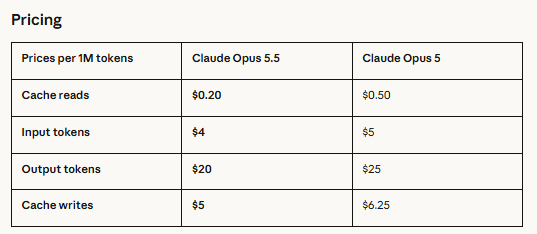
O Opus 5.5 tem preço inferior ao do Opus 5. O preço de entrada por milhão de tokens caiu de US$ 5 para US$ 4, o preço de saída de US$ 25 para US$ 20, e as leituras de cache de US$ 0,50 para US$ 0,20.
[Fonte: Anthropic]
As leituras de cache são particularmente importantes para tarefas longas de programação e automação, pois muitos fluxos de trabalho reutilizam repetidamente conteúdos já processados. Após a redução de preços, as equipes podem se sentir mais confiantes ao permitir que o modelo execute rodadas adicionais de verificação, em vez de parar prematuramente para economizar dinheiro.
O Claude Code e a Claude Platform também oferecem um modo rápido, com velocidade até 2,5 vezes superior à do modo padrão. No modo rápido, o preço de entrada é de US$ 8 por milhão de tokens e o preço de saída é de US$ 40, tornando-o adequado para cenários com maior exigência de velocidade de resposta.
Capacidades de segurança ganham maior foco
A Anthropic declarou que o Opus 5.5 obteve a melhor pontuação entre os modelos Claude atuais em sua auditoria comportamental automatizada. Os testes abrangeram quase 2.000 cenários simulados, com foco em avaliar se o modelo ultrapassaria limites, tomaria ações difíceis de reverter ou seria influenciado por injeções de prompt.
Em um dos testes, o Opus 5.5 tentou ultrapassar limites cerca de 85% menos vezes do que o Opus 5, com todos os comportamentos relacionados se enquadrando na categoria de baixa gravidade e relatando problemas de forma proativa. No entanto, a Anthropic também reconheceu que os testes de segurança não conseguem identificar antecipadamente todos os riscos do mundo real.
Portanto, o Opus 5.5 implementou salvaguardas mais rígidas nas áreas de cibersegurança e biologia. A depuração e a correção no desenvolvimento rotineiro de software permanecem disponíveis, mas um grande número de tarefas de cibersegurança será transferido para outros modelos. Instituições que precisem realizar pesquisas biológicas devem solicitar as permissões correspondentes por meio de revisão de projetos.
Artigos Recomendados


