


SpaceX AI revela Grok 4.7: geração flagship para programação e trabalho intelectual com o mesmo preço do Grok 4.6
TradingKey - SpaceXAI (SPXC – divisão de IA, anteriormente xAI) lançou o Grok 4.7 em 21 de setembro, posicionando-o oficialmente como sua geração de modelos mais capaz para programação e trabalho de conhecimento até o momento. Os preços permanecem consistentes com os do Grok 4.6: US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída. No CursorBench 4.0, que avalia especificamente tarefas de programação de longa duração, o Grok 4.7 atingiu 46,3%, 5,9 pontos percentuais a mais que o Grok 4.6, com declarações oficiais colocando-o na fronteira de custo-benefício em sua faixa de preço nesse benchmark.
Nos últimos dois anos, os aprimoramentos de capacidade nos modelos de ponta tipicamente culminaram em preços unitários por token mais altos: atualizações generacionais, aumentos de preços e, em seguida, a espera para que a indústria absorvesse gradualmente os custos de inferência. O Grok 4.7 segue um caminho diferente: ao mesmo tempo em que eleva a capacidade, seus preços e velocidade de inferência permanecem no nível do Grok 4.6, acompanhados por uma versão rápida adicional que dobra a velocidade de saída.
Os detalhes divulgados oficialmente concentram-se em quatro aspectos: mudanças no modelo base e no treinamento por aprendizado por reforço, comparações horizontais e verticais em sete benchmarks, estruturas de custos em tarefas de longa duração e uma pilha de proteções de segurança completamente reescrita. Além disso, com efeito imediato, o modelo está disponível simultaneamente no Cursor, Grok Build, Grok API e em plataformas de roteamento de modelos e frameworks de programação de terceiros.
A principal proposta de valor do Grok 4.7 centra-se em três capacidades: programação de tarefas de longa duração, geração de documentos profissionais e proteções de segurança. Todas as três compartilham a mesma estrutura de preços — oferecendo o mesmo preço e velocidade da geração anterior —, enquanto utilizam uma versão rápida para atender a cenários sensíveis à latência.
Os benchmarks oficiais indicam que o avanço nesta geração de modelos é contínuo: o CursorBench 4.0 subiu 5,9 pontos percentuais, o Terminal-Bench 4.0 quase dobrou, o AA Briefcase ganhou 111 pontos e o modelo alcançou a pontuação mais alta da empresa em benchmarks de biossegurança. Ao mesmo tempo, o nível absoluto de 19,6% em benchmarks jurídicos e a liderança do Fable 5.1 em quatro benchmarks demonstram que esta continua sendo uma rodada de competição com ganhos e perdas para ambos os lados, em vez de uma substituição unilateral.
Preços e Velocidade Permanecem Inalterados
O Grok 4.7 tem preço inicial de US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída, idêntico ao do Grok 4.6, enquanto mantém a mesma velocidade de inferência. Uma versão rápida oficial também está disponível, oferecendo o dobro da velocidade de saída da versão padrão pelo dobro do preço.
Essa precificação está na faixa mais baixa entre modelos comparáveis. Em comparação, o GPT-5.6 Sol custa US$ 4 para entrada e US$ 20 para saída em seu nível máximo, enquanto o Fable 5.1 custa US$ 10 para entrada e US$ 50 para saída em seu nível máximo. Comparando apenas os preços unitários de saída, o Grok 4.7 custa cerca de um terço do primeiro e aproximadamente um oitavo do segundo.
O impacto prático de manter os preços inalterados são custos de migração gerenciáveis. As equipes que já utilizam o Grok 4.6 podem alternar os modelos diretamente no Cursor ou no Grok Build e executar um teste comparativo com suas suítes de tarefas existentes, sem necessidade de alterações em APIs ou métodos de invocação.
Melhorias no Modelo
A fase de aprendizado por reforço do Grok 4.7 também contou com tempos de treinamento mais longos, com a complexidade geral das tarefas de treinamento se deslocando para cima e o peso se voltando para problemas que exigem horas para serem concluídos. O resultado direto oficial é que o modelo consegue verificar melhor suas próprias respostas e gerenciar contextos longos.
Outra mudança ocorreu nos objetivos de treinamento. O Grok 4.7 foi treinado para compreender nativamente a estrutura do Grok Bot, oferecendo um desempenho melhor em tarefas conversacionais e trabalhos de conhecimento geral. A SpaceXAI lançou o Grok Bot em 11 de agosto, descrevendo-o como um conjunto de agentes em execução contínua, cada um equipado com seu próprio computador e capaz de operar dentro de ferramentas e aplicações.
As capacidades de geração de documentos e apresentações foram destacadas separadamente. Oficialmente, o Grok 4.7 apresenta melhorias expressivas em relação ao Grok 4.6 em ambas as categorias de resultados, atuando em pé de igualdade com outros modelos de ponta.
Placar de Sete Benchmarks
O Grok 4.7 apresenta um desempenho superior na criação de documentos e apresentações. Nos testes GDPval e AA Briefcase, exige-se que a IA realize o trabalho de profissionais como advogados, enfermeiros e analistas financeiros. O Grok 4.7 superou o Grok 4.6 em ambos os testes de benchmark e alcançou um desempenho equivalente ao de outros modelos de ponta.
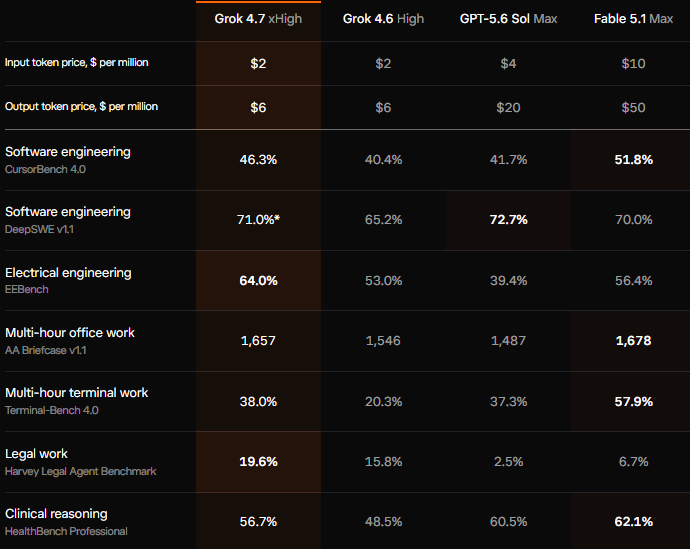
[Tabela comparativa oficial abrangendo programação, operações de terminal, engenharia elétrica, direito, raciocínio clínico e tarefas de escritório. Fonte: x.ai]
Direito e operações de terminal apresentaram as maiores melhorias. No Harvey Legal Agent Benchmark, o Grok 4.7 registrou 19,6%, a maior pontuação do grupo, enquanto o GPT-5.6 Sol obteve apenas 2,5%; no Terminal-Bench 4.0, o Grok 4.7 saltou dos 20,3% do Grok 4.6 para 38,0%, quase dobrando. O raciocínio clínico evoluiu 8,2 pontos percentuais, e as pontuações em tarefas de escritório aumentaram 111 pontos.
A Curva de Custos em Tarefas de Longa Duração
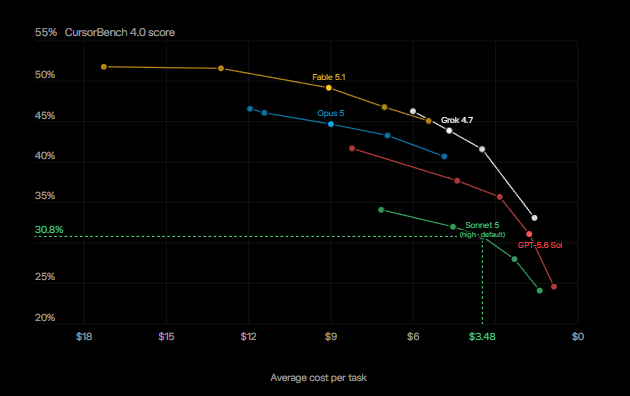
A página oficial do CursorBench 4.0 apresenta três gráficos lado a lado: custo médio por tarefa, média de tokens de saída e média de etapas, com o eixo vertical padronizado para o mesmo conjunto de pontuações. O ponto de referência nos gráficos está marcado no Sonnet 5 (configuração padrão alta): uma pontuação de 30,8%, US$ 3,48 por tarefa, aproximadamente 61.000 tokens de saída e 85 etapas, servindo como linha de base para a comparação de custo-eficiência.
[Fonte: X.ai]
Analisando a curva de custo, o Fable 5.1 atinge a pontuação mais alta, a um custo de quase US$ 18 por tarefa; o GPT-5.6 Sol fica no lado de baixo custo, com sua pontuação caindo de forma mais acentuada à medida que o custo diminui. O Grok 4.7 fica entre os dois, com alegações oficiais colocando-o na fronteira de custo-benefício nesse benchmark. O formato dos gráficos de tokens de saída e do número de etapas espelha o gráfico de custos, indicando que as diferenças de custo decorrem principalmente da extensão do raciocínio necessário para concluir as tarefas, e não do preço unitário em si.
Imagine uma equipe de backend de seis pessoas migrando um serviço de 400.000 linhas de um framework antigo para um novo. Dividir esse tipo de tarefa em commits de etapa única não faz sentido; o modelo deve trabalhar continuamente por horas e verificar sozinho os resultados das etapas anteriores ao longo do caminho — exatamente o cenário que o CursorBench 4.0 e o Terminal-Bench 4.0 buscam medir. Apenas quando o custo por tarefa cair de mais de dez dólares para alguns dólares é que uma equipe provavelmente conseguirá encaixá-la nas rotinas diárias, em vez de esperar para processá-la em lotes no fim de semana.
Segurança e Cibersegurança
O Grok 4.7 utiliza um stack de segurança totalmente novo. Oficialmente, ele é descrito como o modelo mais forte da empresa testado até o momento, tanto em taxa de recusa quanto em resistência a jailbreaks.
Em domínios de uso duplo, como cibersegurança e biossegurança, os dados oficiais abrangem ambos os lados: manter a usabilidade para tarefas legítimas e, ao mesmo tempo, recusar solicitações perigosas. Em biossegurança, o Grok 4.7 atingiu 62,4% no benchmark de biossegurança LatchBio, a pontuação mais alta no benchmark. Em cibersegurança, o benchmark interno HackerBench v0.3 mostrou que o modelo permitiu apenas 3,3% dos prompts de uso duplo de alto risco, enquanto raramente bloqueou pesquisas de segurança legítimas.
A SpaceXAI também afirmou que começou a oferecer acesso apenas por convite às funcionalidades de red-teaming do Grok 4.7 para parceiros selecionados de cibersegurança voltados à pesquisa defensiva.
Artigos Recomendados


